
- Katılım
- 13 Ocak 2026
- Mesajlar
- 239
- Tepkime puanı
- 102
- Puan
- 43
Merhaba arkadaşlar, yapay zekâ modellerinde yalnızca daha büyük sistemler yarışmıyor. Nvidia’nın yayımladığı Nemotron 3.5 Bolt E4B 4GB, cihaz üzerinde çalışan, hızlı yanıt veren ve uygulamalardaki araçları kullanabilen küçük asistanlara odaklanıyor. Model, Google’ın Gemma 4 E4B tabanı üzerine Nvidia’nın ek eğitim yöntemleriyle geliştirilmiş. Şirketin 23 Ekim tarihli araştırma sayfasında sohbet, oyun karakterleri, robotlar ve cihaz kontrolü başlıca kullanım alanları olarak sıralanıyor.
“4 GB” hangi koşulu anlatıyor?
İsimdeki bellek vurgusunu biraz açmakta fayda var. Nvidia, hedeflenen iş yüklerinde yaklaşık 4 GB’a sığabilen yerel deneyimler amaçlıyor. Ancak bu, her görevde ve her bağlam uzunluğunda değişmeyen bir tüketim anlamına gelmiyor. Şirketin tablosunda RTX 5070 üzerinde kısa iş yükü için 3,5 GB, daha uzun önbellekli senaryo için 4,3 GB kullanım görülüyor. Jetson Orin Nano 8GB tarafındaki karşılıklar ise 4,2 ve 4,9 GB.
Bu ölçümler Q4_K_M yapılandırmasıyla, llama.cpp üzerinden ve aynı anda tek oturumla alınmış. Dolayısıyla cihazın toplam belleği, uygulamanın diğer parçaları ve seçilen çalışma koşulları birlikte değerlendirilmeli. “4 GB belleği olan her cihazda bütün özellikleri rahatça kullanırım” sonucuna doğrudan varmak yanıltıcı olur. Kaynak, sonuçların donanım ve yazılım yapılandırmasına göre değişebileceğini açıkça belirtiyor.
Sohbetten uygulama araçlarına uzanan görevler
Bolt E4B, konuşma boyunca uygulama API’lerini çağırarak işlemler yürütebiliyor. Bu yaklaşım, yalnızca bir soruya metinle karşılık vermenin ötesine geçiyor. Modelin hangi aracı ne zaman kullanacağını, eksik bilgi varsa ne soracağını ve gelen sonucu nasıl değerlendireceğini de ele almak gerekiyor. Nvidia’nın değerlendirmelerinde bu nedenle talimatlara uyma, konuşmalar arasında tutarlılık ve araç çağrıları ayrı başlıklarda incelenmiş.
Konuşma modu daha kısa ve sesli iletişime uygun cevapları teşvik ediyor. Akıl yürütme ise karmaşık isteklerde açılabiliyor; hızlı cevap gerektiren durumlarda kapatılabiliyor veya süre hedefleri için sınırlandırılabiliyor. 64 bin tokenlık bağlam alanına konuşma geçmişi, talimatlar, araç tanımları ve uygulama durumu yerleştirilebiliyor. Şirket 35 dil desteği bildiriyor; temel modelin ön eğitiminde 140’tan fazla dil bulunduğunu da ekliyor.
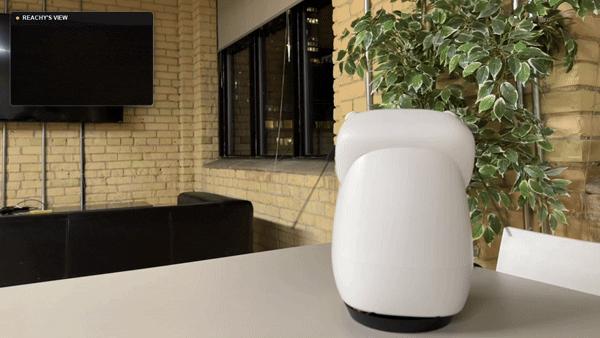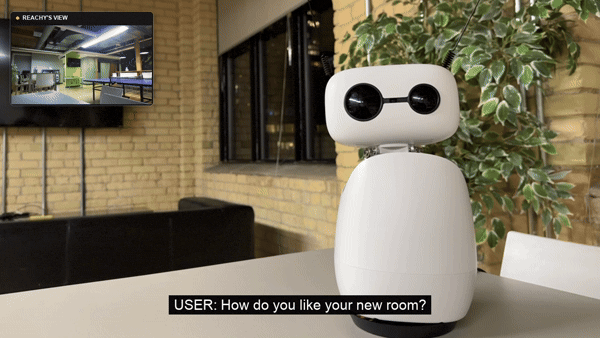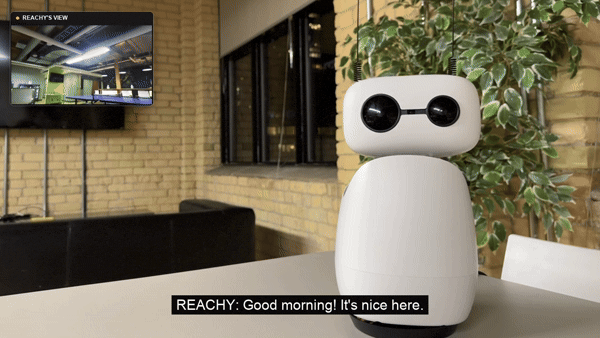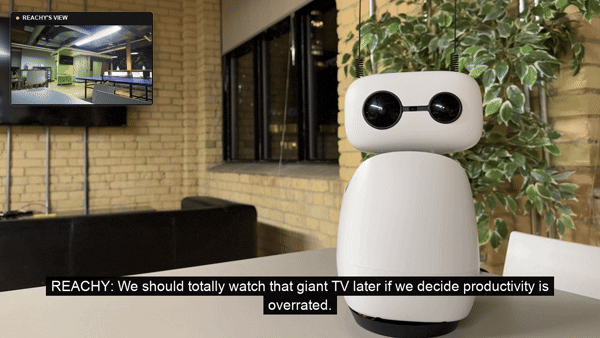
Jetson Orin Nano 8GB üzerinde Reachy Mini demosu. Görsel ve demo: NVIDIA.
Robot ve oyun demosunda neler oluyor?
Reachy Mini örneğinde model robotun animasyon kütüphanesindeki betikleri çağırıyor ve konuşmalı yanıtları yönetiyor. Çevrenin görsel olarak anlaşılması tarafında ise Cosmos 3 Edge bulunuyor. Bu ayrım önemli: Bütün algı, hareket ve konuşma yeteneklerini tek başına Bolt E4B’ye atfetmemek gerekiyor. Gösterilen deneyim, birlikte çalışan bileşenlerin oluşturduğu bir sistem.
Oyun örneğinde bir demirci tüccar karakteri, eşya için doğru ödemenin yapılıp yapılmadığını kontrol ediyor. Ardından üretim tarifini incelemek, malzemeleri toplamak, eşyayı hazırlamak ve oyuncuya aktarmak için araçlar çağırıyor. Böylece sohbet ile oyun içindeki eylemler birbirine bağlanmış oluyor. Bunlar Nvidia’nın sunduğu demolar; her oyunda veya robotta hazır ve sorunsuz çalışacak genel bir çözüm garantisi olarak okunmamalı.
Performans rakamlarını nasıl okumalıyız?
Nvidia, seçtiği testler genelinde önceki Nano 4B modeline göre yaklaşık yüzde 40 daha yüksek ortalama puan ve akıl yürütmeli karşılaştırmalarda rakiplere göre yüzde 80’e kadar daha az çıktı tokenı bildiriyor. Bunlar şirketin kendi değerlendirmeleri. Ayrıca tablolar, Bolt’un her testte en yüksek puanı almadığını gösteriyor. Örneğin araç kullanımının bazı ölçümlerinde başka modeller önde. Uygulamaya uygun seçim için tek ortalamanın ötesine bakmak gerekiyor.
Benim için bu duyurunun ilginç tarafı, yerel asistanın bellek ve gecikme sınırlarıyla birlikte ele alınması. Model Hugging Face, Ollama ve çeşitli geliştirme ortamlarında erişime sunulmuş; eğitim tarifleri ve entegrasyon yönergeleri de paylaşılmış. Yerel çalıştırma buluta veri gönderme ihtiyacını azaltabilir, ancak uygulamanın kullandığı dış araçlar ayrıca değerlendirilmelidir. Siz böyle bir modeli önce masaüstü asistanında mı, yoksa oyun karakterlerinde mi görmek isterdiniz?
Kaynak: NVIDIA Research – Nemotron 3.5 Bolt E4B 4GB duyurusu ve ölçümleri.
“4 GB” hangi koşulu anlatıyor?
İsimdeki bellek vurgusunu biraz açmakta fayda var. Nvidia, hedeflenen iş yüklerinde yaklaşık 4 GB’a sığabilen yerel deneyimler amaçlıyor. Ancak bu, her görevde ve her bağlam uzunluğunda değişmeyen bir tüketim anlamına gelmiyor. Şirketin tablosunda RTX 5070 üzerinde kısa iş yükü için 3,5 GB, daha uzun önbellekli senaryo için 4,3 GB kullanım görülüyor. Jetson Orin Nano 8GB tarafındaki karşılıklar ise 4,2 ve 4,9 GB.
Bu ölçümler Q4_K_M yapılandırmasıyla, llama.cpp üzerinden ve aynı anda tek oturumla alınmış. Dolayısıyla cihazın toplam belleği, uygulamanın diğer parçaları ve seçilen çalışma koşulları birlikte değerlendirilmeli. “4 GB belleği olan her cihazda bütün özellikleri rahatça kullanırım” sonucuna doğrudan varmak yanıltıcı olur. Kaynak, sonuçların donanım ve yazılım yapılandırmasına göre değişebileceğini açıkça belirtiyor.
Sohbetten uygulama araçlarına uzanan görevler
Bolt E4B, konuşma boyunca uygulama API’lerini çağırarak işlemler yürütebiliyor. Bu yaklaşım, yalnızca bir soruya metinle karşılık vermenin ötesine geçiyor. Modelin hangi aracı ne zaman kullanacağını, eksik bilgi varsa ne soracağını ve gelen sonucu nasıl değerlendireceğini de ele almak gerekiyor. Nvidia’nın değerlendirmelerinde bu nedenle talimatlara uyma, konuşmalar arasında tutarlılık ve araç çağrıları ayrı başlıklarda incelenmiş.
Konuşma modu daha kısa ve sesli iletişime uygun cevapları teşvik ediyor. Akıl yürütme ise karmaşık isteklerde açılabiliyor; hızlı cevap gerektiren durumlarda kapatılabiliyor veya süre hedefleri için sınırlandırılabiliyor. 64 bin tokenlık bağlam alanına konuşma geçmişi, talimatlar, araç tanımları ve uygulama durumu yerleştirilebiliyor. Şirket 35 dil desteği bildiriyor; temel modelin ön eğitiminde 140’tan fazla dil bulunduğunu da ekliyor.
Jetson Orin Nano 8GB üzerinde Reachy Mini demosu. Görsel ve demo: NVIDIA.
Robot ve oyun demosunda neler oluyor?
Reachy Mini örneğinde model robotun animasyon kütüphanesindeki betikleri çağırıyor ve konuşmalı yanıtları yönetiyor. Çevrenin görsel olarak anlaşılması tarafında ise Cosmos 3 Edge bulunuyor. Bu ayrım önemli: Bütün algı, hareket ve konuşma yeteneklerini tek başına Bolt E4B’ye atfetmemek gerekiyor. Gösterilen deneyim, birlikte çalışan bileşenlerin oluşturduğu bir sistem.
Oyun örneğinde bir demirci tüccar karakteri, eşya için doğru ödemenin yapılıp yapılmadığını kontrol ediyor. Ardından üretim tarifini incelemek, malzemeleri toplamak, eşyayı hazırlamak ve oyuncuya aktarmak için araçlar çağırıyor. Böylece sohbet ile oyun içindeki eylemler birbirine bağlanmış oluyor. Bunlar Nvidia’nın sunduğu demolar; her oyunda veya robotta hazır ve sorunsuz çalışacak genel bir çözüm garantisi olarak okunmamalı.
Performans rakamlarını nasıl okumalıyız?
Nvidia, seçtiği testler genelinde önceki Nano 4B modeline göre yaklaşık yüzde 40 daha yüksek ortalama puan ve akıl yürütmeli karşılaştırmalarda rakiplere göre yüzde 80’e kadar daha az çıktı tokenı bildiriyor. Bunlar şirketin kendi değerlendirmeleri. Ayrıca tablolar, Bolt’un her testte en yüksek puanı almadığını gösteriyor. Örneğin araç kullanımının bazı ölçümlerinde başka modeller önde. Uygulamaya uygun seçim için tek ortalamanın ötesine bakmak gerekiyor.
Benim için bu duyurunun ilginç tarafı, yerel asistanın bellek ve gecikme sınırlarıyla birlikte ele alınması. Model Hugging Face, Ollama ve çeşitli geliştirme ortamlarında erişime sunulmuş; eğitim tarifleri ve entegrasyon yönergeleri de paylaşılmış. Yerel çalıştırma buluta veri gönderme ihtiyacını azaltabilir, ancak uygulamanın kullandığı dış araçlar ayrıca değerlendirilmelidir. Siz böyle bir modeli önce masaüstü asistanında mı, yoksa oyun karakterlerinde mi görmek isterdiniz?
Kaynak: NVIDIA Research – Nemotron 3.5 Bolt E4B 4GB duyurusu ve ölçümleri.