
- Katılım
- 13 Ocak 2026
- Mesajlar
- 243
- Tepkime puanı
- 102
- Puan
- 43
Merhaba arkadaşlar, Moonshot AI yeni Kimi K3.1 Pro modelini tanıttı. Şirketin resmî yazısında kodlama, üç boyutlu tasarım, finansal araştırma ve çok adımlı görevler öne çıkarılıyor. Bir milyon tokenlık bağlam penceresi sunan model, Kimi ürünlerinde erişime açılmış durumda. Tam model ağırlıklarının paylaşılması içinse 4 Kasım 2026’ya kadar uzanan ayrı bir takvim açıklanıyor. Bu iki erişim biçimini birbirine karıştırmamakta fayda var.
Daha fazla ek eğitim, daha uzun görevler
K3.1 Pro, Kimi K3 üzerine ek eğitim uygulanarak geliştirilmiş. Moonshot, pekiştirmeli öğrenme için ayırdığı hesaplama kaynağını artırdığını; eğitim altyapısı, uzun bağlam işleme ve test ortamları üzerinde iyileştirmeler yaptığını belirtiyor. Amaç, yalnızca kısa bir yanıt üretmekten daha kapsamlı işlere geçebilmek. Bir kod tabanında sorunu incelemek, araç kullanmak ve sonucu tekrar değerlendirmek bu tür işlerin mantığını açıklayan örnekler.
Bir milyon tokenlık bağlam, uzun belgeleri ve kapsamlı görev bilgisini aynı çalışma içinde tutmak açısından dikkat çekiyor. Ancak büyük bir bağlam alanı, içindeki her bilginin her görevde kusursuz kullanılacağı garantisi değil. Kullanıcı açısından önemli olan, modelin verilen belgelerden doğru sonuç çıkarabilmesi ve yaptığı işi kontrol edilebilir biçimde tamamlaması. Şirketin sunduğu testler de farklı yetenekleri ayrı ayrı ölçmeye çalışıyor.
Kodlama sonuçlarında ne açıklanıyor?
Moonshot’ın yayımladığı karşılaştırmada K3.1 Pro, Terminal-Bench 4.0’da yüzde 65,7 puan alıyor. Aynı tabloda GPT-6 Astra yüzde 58,2, Claude Opus 5.5 ise yüzde 66,4 olarak veriliyor. Bu test, terminal ortamında gerçekçi ve kaynakları sınırlı görevlerde çalışan kodlama ajanlarını değerlendiriyor. Sonuçlar, bütün yazılım işlerinde aynı sıralamanın oluşacağını gösteren genel bir hüküm değil.
Şirketin kendi uzun görev testinde de K3’ün yüzde 55,95 puanından K3.1 Pro’nun yüzde 61,2 puanına yükseliş bildiriliyor. İç testlerin, geliştiricinin seçtiği görevleri ve değerlendirme koşullarını yansıttığını hatırlayalım. Resmî yazının dipnotlarında kullanılan araç altyapıları ve akıl yürütme ayarları da açıklanmış. Bu ayrıntılar, puanları yalnızca model adları üzerinden karşılaştırmanın neden eksik kalabileceğini gösteriyor.
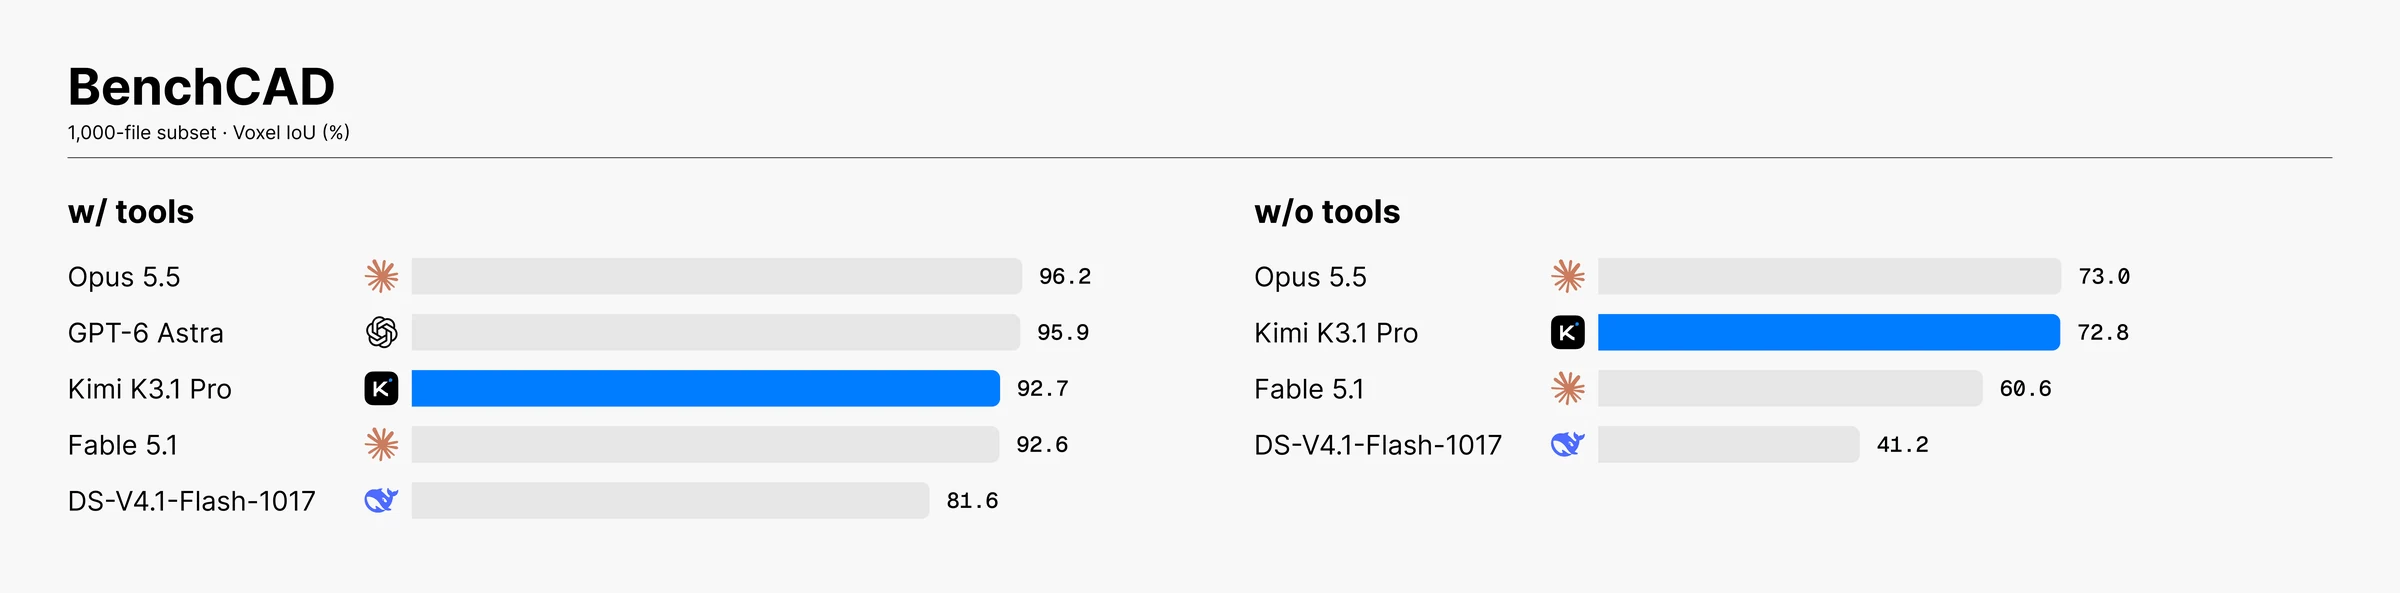
Moonshot AI’ın yayımladığı BenchCAD karşılaştırması. Görsel ve ölçümler: Kimi/Moonshot AI.
Üç boyutlu tasarımda araçların etkisi
Modelin Blender ve CAD yazılımları için betikler üretebildiği, geometri ve sahne düzenini değiştirebildiği aktarılıyor. BenchCAD’de araçlarla birlikte alınan yüzde 92,7 sonucu, Claude Opus 5.5’in yüzde 96,2 ve GPT-6 Astra’nın yüzde 95,9 puanına yaklaşıyor. Bu sonuç, farklı açılardan görüntülenen nesnelerin CAD kodu yoluyla yeniden oluşturulmasına ilişkin bir ölçüm.
Örneğin bir mobilyanın ölçülerini değiştirerek alternatifler üretmek, parametrik tasarımın kullanım mantığını anlatıyor. Ancak iyi görünen bir üç boyutlu modelin bütün üretim koşullarını karşıladığını ayrıca doğrulamak gerekir. Moonshot’ın araştırma yazısındaki görsel ve testler, tasarım yeteneğini gösteriyor; her fiziksel ürün için mühendislik onayı yerine geçmiyor.
Güvenlik ve doğruluk iddialarının sınırı
Moonshot, kötüye kullanım riskini azaltmak için bazı siber güvenlik verilerini eğitim aşamalarından çıkardığını söylüyor. Bunun ilgili yetenekleri azalttığını, fakat genel kodlama ve hata ayıklama becerilerinin güvenlik görevlerine de aktarılabildiğini belirtiyor. Yani açıklama, modelin bu alanda tamamen etkisiz hâle getirildiği şeklinde okunmamalı.
Doğruluk konusunda da şirketin zorlayıcı iç testinde hatalı iddia oranının K3’e göre düştüğü bildiriliyor. Kaynak, bu stres testi oranlarının günlük kullanımın genel hata oranı olmadığını özellikle açıklıyor. Bence bu ayrım, bir modeli araştırma veya belge işlerinde kullanırken sonuçları nasıl yorumlayacağımız açısından önemli.
K3.1 Pro; Kimi web ve mobil uygulamaları, Kimi Work, Kimi Code ve API üzerinden sunuluyor. Highspeed sürümü için iki ila üç kat hız iddiası bulunuyor. Benim merak ettiğim, uzun görevlerdeki gelişimin günlük işlerde ne kadar hissedileceği. Siz önce kodlama, üç boyutlu tasarım veya belge araştırmasından hangisini denemek isterdiniz?
Kaynak: Kimi/Moonshot AI – Kimi K3.1 Pro resmî tanıtım ve değerlendirme yazısı.
Daha fazla ek eğitim, daha uzun görevler
K3.1 Pro, Kimi K3 üzerine ek eğitim uygulanarak geliştirilmiş. Moonshot, pekiştirmeli öğrenme için ayırdığı hesaplama kaynağını artırdığını; eğitim altyapısı, uzun bağlam işleme ve test ortamları üzerinde iyileştirmeler yaptığını belirtiyor. Amaç, yalnızca kısa bir yanıt üretmekten daha kapsamlı işlere geçebilmek. Bir kod tabanında sorunu incelemek, araç kullanmak ve sonucu tekrar değerlendirmek bu tür işlerin mantığını açıklayan örnekler.
Bir milyon tokenlık bağlam, uzun belgeleri ve kapsamlı görev bilgisini aynı çalışma içinde tutmak açısından dikkat çekiyor. Ancak büyük bir bağlam alanı, içindeki her bilginin her görevde kusursuz kullanılacağı garantisi değil. Kullanıcı açısından önemli olan, modelin verilen belgelerden doğru sonuç çıkarabilmesi ve yaptığı işi kontrol edilebilir biçimde tamamlaması. Şirketin sunduğu testler de farklı yetenekleri ayrı ayrı ölçmeye çalışıyor.
Kodlama sonuçlarında ne açıklanıyor?
Moonshot’ın yayımladığı karşılaştırmada K3.1 Pro, Terminal-Bench 4.0’da yüzde 65,7 puan alıyor. Aynı tabloda GPT-6 Astra yüzde 58,2, Claude Opus 5.5 ise yüzde 66,4 olarak veriliyor. Bu test, terminal ortamında gerçekçi ve kaynakları sınırlı görevlerde çalışan kodlama ajanlarını değerlendiriyor. Sonuçlar, bütün yazılım işlerinde aynı sıralamanın oluşacağını gösteren genel bir hüküm değil.
Şirketin kendi uzun görev testinde de K3’ün yüzde 55,95 puanından K3.1 Pro’nun yüzde 61,2 puanına yükseliş bildiriliyor. İç testlerin, geliştiricinin seçtiği görevleri ve değerlendirme koşullarını yansıttığını hatırlayalım. Resmî yazının dipnotlarında kullanılan araç altyapıları ve akıl yürütme ayarları da açıklanmış. Bu ayrıntılar, puanları yalnızca model adları üzerinden karşılaştırmanın neden eksik kalabileceğini gösteriyor.
Moonshot AI’ın yayımladığı BenchCAD karşılaştırması. Görsel ve ölçümler: Kimi/Moonshot AI.
Üç boyutlu tasarımda araçların etkisi
Modelin Blender ve CAD yazılımları için betikler üretebildiği, geometri ve sahne düzenini değiştirebildiği aktarılıyor. BenchCAD’de araçlarla birlikte alınan yüzde 92,7 sonucu, Claude Opus 5.5’in yüzde 96,2 ve GPT-6 Astra’nın yüzde 95,9 puanına yaklaşıyor. Bu sonuç, farklı açılardan görüntülenen nesnelerin CAD kodu yoluyla yeniden oluşturulmasına ilişkin bir ölçüm.
Örneğin bir mobilyanın ölçülerini değiştirerek alternatifler üretmek, parametrik tasarımın kullanım mantığını anlatıyor. Ancak iyi görünen bir üç boyutlu modelin bütün üretim koşullarını karşıladığını ayrıca doğrulamak gerekir. Moonshot’ın araştırma yazısındaki görsel ve testler, tasarım yeteneğini gösteriyor; her fiziksel ürün için mühendislik onayı yerine geçmiyor.
Güvenlik ve doğruluk iddialarının sınırı
Moonshot, kötüye kullanım riskini azaltmak için bazı siber güvenlik verilerini eğitim aşamalarından çıkardığını söylüyor. Bunun ilgili yetenekleri azalttığını, fakat genel kodlama ve hata ayıklama becerilerinin güvenlik görevlerine de aktarılabildiğini belirtiyor. Yani açıklama, modelin bu alanda tamamen etkisiz hâle getirildiği şeklinde okunmamalı.
Doğruluk konusunda da şirketin zorlayıcı iç testinde hatalı iddia oranının K3’e göre düştüğü bildiriliyor. Kaynak, bu stres testi oranlarının günlük kullanımın genel hata oranı olmadığını özellikle açıklıyor. Bence bu ayrım, bir modeli araştırma veya belge işlerinde kullanırken sonuçları nasıl yorumlayacağımız açısından önemli.
K3.1 Pro; Kimi web ve mobil uygulamaları, Kimi Work, Kimi Code ve API üzerinden sunuluyor. Highspeed sürümü için iki ila üç kat hız iddiası bulunuyor. Benim merak ettiğim, uzun görevlerdeki gelişimin günlük işlerde ne kadar hissedileceği. Siz önce kodlama, üç boyutlu tasarım veya belge araştırmasından hangisini denemek isterdiniz?
Kaynak: Kimi/Moonshot AI – Kimi K3.1 Pro resmî tanıtım ve değerlendirme yazısı.