
- Katılım
- 13 Ocak 2026
- Mesajlar
- 277
- Tepkime puanı
- 102
- Puan
- 43
Merhaba arkadaşlar!
Yapay zekâ modellerinin en bilinen sınırlarından biri hakkında ilginç bir araştırma yayımlandı. Google Research, 27 Ekim 2026 tarihli blog yazısında büyük dil modelleri (LLM) için bir “uyku çerçevesi” (sleep framework) tanıttı. Yazı Ali Behrouz ve Vahab Mirrokni imzalı; araştırma Google, Cornell Üniversitesi ve Güney Kaliforniya Üniversitesi’nden isimlerle yürütülmüş.
Çözülmeye çalışılan sorun: Bilgi sınırı ve “yıkıcı unutma”
Bugünkü dil modelleri eğitildikten sonra büyük ölçüde sabit kalıyor ve belirli bir bilgi kesim tarihine bağlı çalışıyor. Sohbet sırasında verdiğiniz bir belgeyi o oturumda kullanabiliyorlar (buna bağlam içi öğrenme, ICL deniyor), ama oturum bitince bu kısa süreli bilgi de gidiyor.
Akla gelen çözüm modeli yeni verilerle sürekli güncellemek. Ancak Google’ın da belirttiği gibi bu, “yıkıcı unutma” (catastrophic forgetting) denen soruna yol açabiliyor: Model yeni bir şey öğrenirken önceden iyi yaptığı işlerde gerileyebiliyor.
Basit bir benzetme yapayım: Her hafta yeni ürün kodlarını öğrenen bir çalışanın, eski kodları unutmaya başladığını düşünün. İstenen şey, yeni bilgiyi eklerken eskiyi de korumak. (Bu benim anlatım için verdiğim bir örnek, araştırmadaki bir deney değil.)
Uyanıklık ve uyku: İki aşamalı döngü
Araştırmacılar, insan beyninin dinlenme sırasında anıları pekiştirmesinden ilham aldıklarını söylüyor. Bu yaklaşımda model iki durum arasında dönüşümlü çalışıyor:
Önemli bir ayrım: Google, “uyku” ve “rüya” gibi terimlerin nörobilimden ödünç alındığını, sistemin ise sabit bir model mimarisi ve insanların tanımladığı eğitim kuralları içinde çalıştığını özellikle vurguluyor. Yani modelin gerçekten uyuduğu ya da rüya gördüğü söylenmiyor; bu bir benzetme.
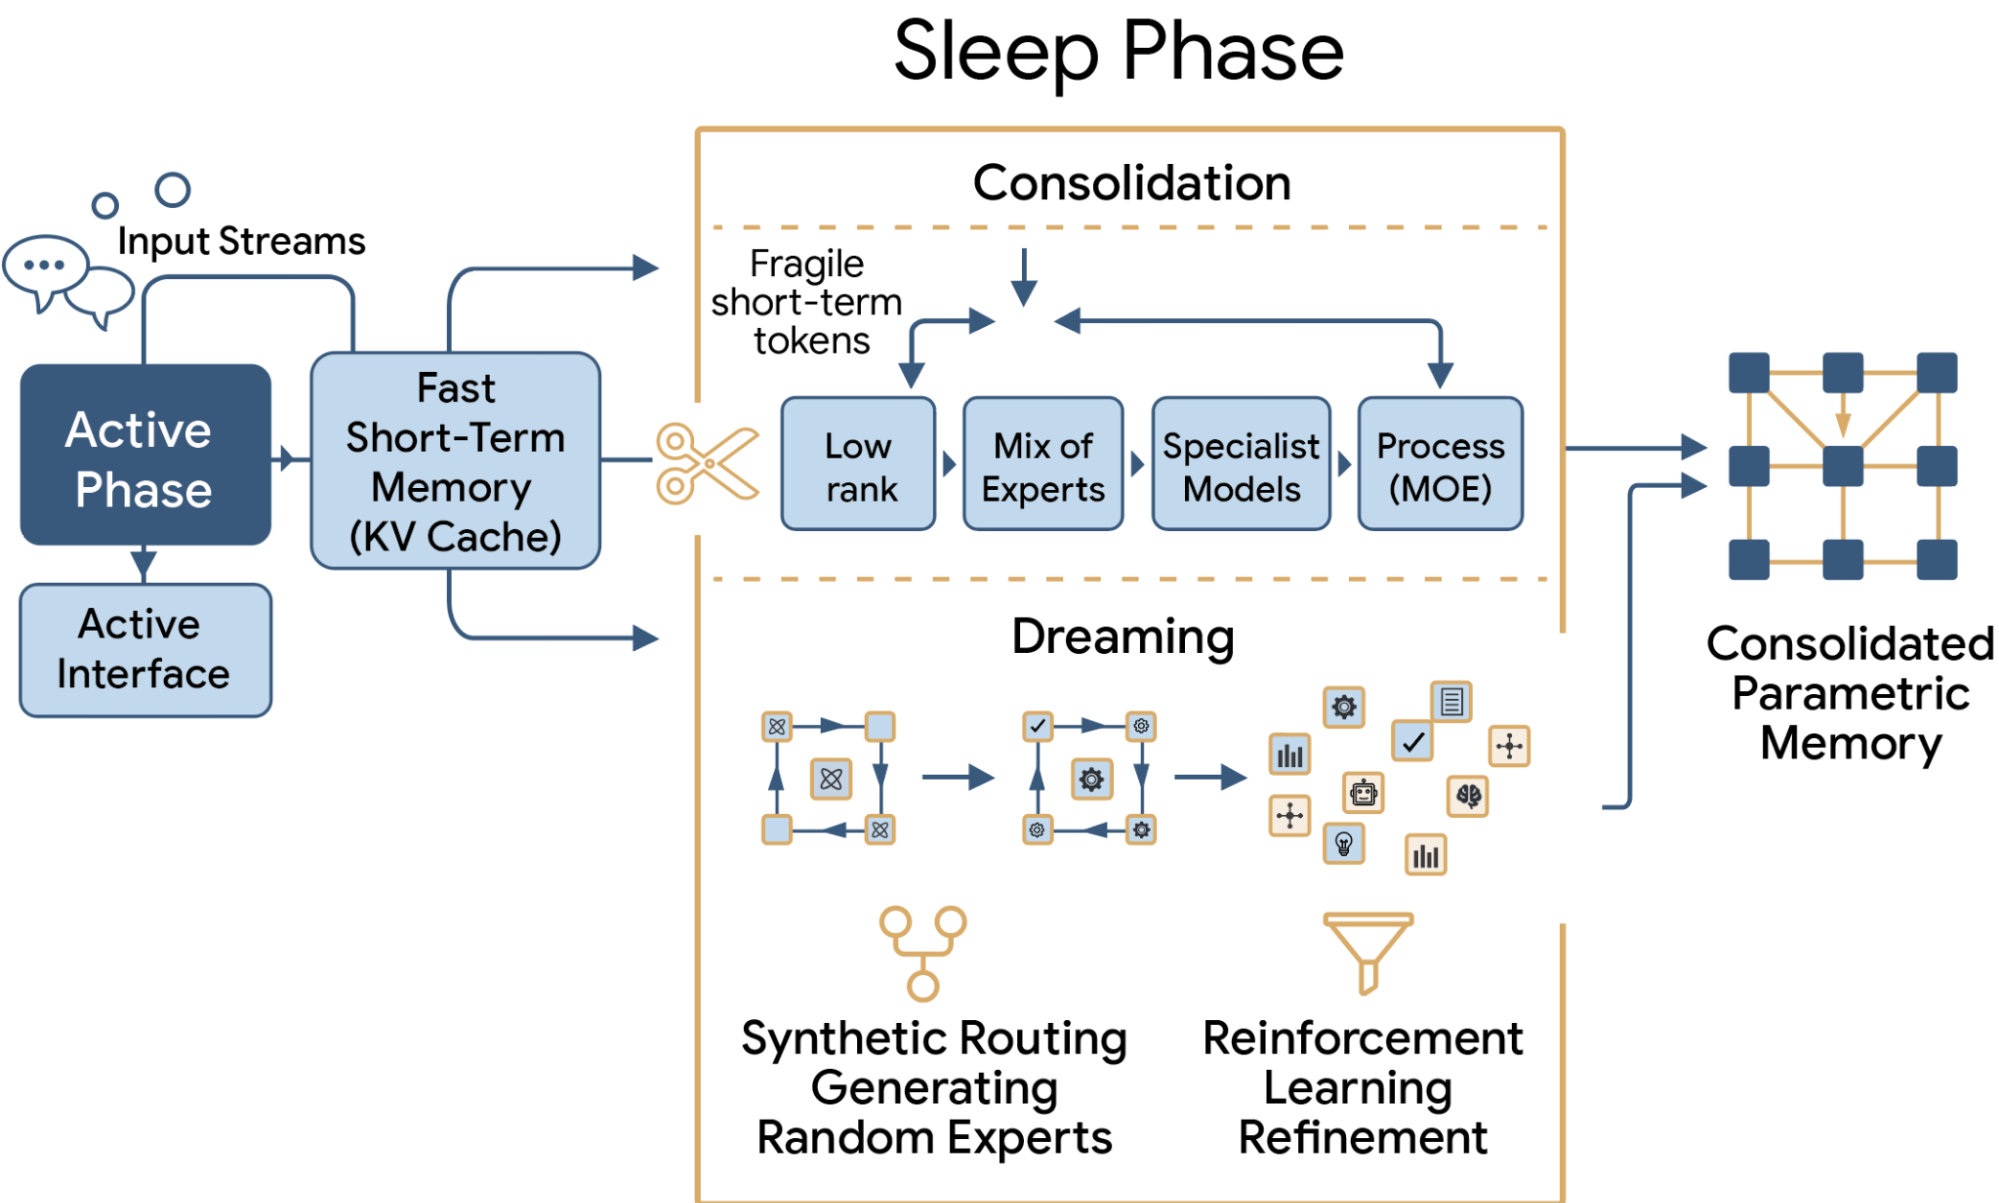
Görsel: Uyku çerçevesinin genel şeması — aktif aşamadan gelen girdiler kısa süreli bellekte tutulup “pekiştirme” ve “rüya” aşamalarına aktarılıyor. Kaynak: Google Research blogu.
Uykuda neler oluyor?
1. Bellek pekiştirme: Uyku sırasında Mixture-of-Experts (MoE) yapısında önceden ayrılmış yeni, düşük dereceli “uzman” blokları açılıyor. Kısa süreli bellekteki bilgiler, bilgi damıtma (distillation) ve pekiştirmeli öğrenme tabanlı taklit yöntemleriyle bu yeni uzun süreli parametrelere aktarılıyor. Amaç, yeni bilgiyi eski parametrelerin üzerine yazmadan saklamak. Aktarım bitince geçici kısa süreli parametreler sıfırlanıyor ve bir sonraki aktif oturuma yer açılıyor.
2. Rüya ile kendini geliştirme: Model kendi sentetik eğitim örneklerini (“rüyalar”) üretiyor. Bu sırada yönlendirici rastgele farklı uzmanları devreye sokarak farklı bilgi alanlarını karıştırıyor. Üretilen örnekler gradyan tabanlı bir seçimle filtreleniyor, en yararlı görünenlerle ince ayar yapılıyor ve bunun alt görevlerde gerçekten iyileşme sağlayıp sağlamadığı değerlendiriliyor.
Araştırmacıların bildirdiği sonuçlar
Aşağıdakiler Google Research’ün kendi blog yazısında paylaşılan sonuçlar:
Bu sonuçlar araştırma ekibinin kendi deneylerine dayanıyor. Blog yazısında yöntemin Gemini gibi bir üründe ne zaman ya da kullanılıp kullanılmayacağına dair bir bilgi yok.
Benim değerlendirmem
Benim değerlendirmem, fikrin asıl çekici tarafının modelin “eğitim” ve “kullanım” arasındaki keskin ayrımı yumuşatma hedefi olduğu yönünde. Yine de bunun şimdilik bir araştırma sonucu olduğunu unutmamak lazım. Bağımsız ekiplerin sonuçları tekrar etmesi, maliyet ve güvenlik tarafının (örneğin modelin yanlış bir bilgiyi de kalıcı olarak “pekiştirmesi” ihtimali) nasıl yönetileceği gibi sorular henüz yanıt bekliyor. Bu nedenle “devrim” demek için erken olduğunu düşünüyorum.
Sizce bir yapay zekâ asistanının konuştuklarınızdan kalıcı olarak öğrenmesi daha çok fayda mı sağlar, yoksa gizlilik ve hata riski açısından endişe mi yaratır?
Asıl kaynak: Google Research Blog – The sleep framework: A new way for LLMs to retain knowledge in continual learning: https://research.google/blog/the-sl...ms-to-retain-knowledge-in-continual-learning/
Yapay zekâ modellerinin en bilinen sınırlarından biri hakkında ilginç bir araştırma yayımlandı. Google Research, 27 Ekim 2026 tarihli blog yazısında büyük dil modelleri (LLM) için bir “uyku çerçevesi” (sleep framework) tanıttı. Yazı Ali Behrouz ve Vahab Mirrokni imzalı; araştırma Google, Cornell Üniversitesi ve Güney Kaliforniya Üniversitesi’nden isimlerle yürütülmüş.
Çözülmeye çalışılan sorun: Bilgi sınırı ve “yıkıcı unutma”
Bugünkü dil modelleri eğitildikten sonra büyük ölçüde sabit kalıyor ve belirli bir bilgi kesim tarihine bağlı çalışıyor. Sohbet sırasında verdiğiniz bir belgeyi o oturumda kullanabiliyorlar (buna bağlam içi öğrenme, ICL deniyor), ama oturum bitince bu kısa süreli bilgi de gidiyor.
Akla gelen çözüm modeli yeni verilerle sürekli güncellemek. Ancak Google’ın da belirttiği gibi bu, “yıkıcı unutma” (catastrophic forgetting) denen soruna yol açabiliyor: Model yeni bir şey öğrenirken önceden iyi yaptığı işlerde gerileyebiliyor.
Basit bir benzetme yapayım: Her hafta yeni ürün kodlarını öğrenen bir çalışanın, eski kodları unutmaya başladığını düşünün. İstenen şey, yeni bilgiyi eklerken eskiyi de korumak. (Bu benim anlatım için verdiğim bir örnek, araştırmadaki bir deney değil.)
Uyanıklık ve uyku: İki aşamalı döngü
Araştırmacılar, insan beyninin dinlenme sırasında anıları pekiştirmesinden ilham aldıklarını söylüyor. Bu yaklaşımda model iki durum arasında dönüşümlü çalışıyor:
- Aktif (uyanık) aşama: Model girdileri alıyor, işliyor ve geçici bilgileri hızlı, kısa süreli bellek bileşenlerinde tutuyor.
- Uyku aşaması: Model yeni girdi almayı durduruyor ve hesaplamasını bellek pekiştirmeye ve kendini geliştirmeye ayırıyor.
Önemli bir ayrım: Google, “uyku” ve “rüya” gibi terimlerin nörobilimden ödünç alındığını, sistemin ise sabit bir model mimarisi ve insanların tanımladığı eğitim kuralları içinde çalıştığını özellikle vurguluyor. Yani modelin gerçekten uyuduğu ya da rüya gördüğü söylenmiyor; bu bir benzetme.
Görsel: Uyku çerçevesinin genel şeması — aktif aşamadan gelen girdiler kısa süreli bellekte tutulup “pekiştirme” ve “rüya” aşamalarına aktarılıyor. Kaynak: Google Research blogu.
Uykuda neler oluyor?
1. Bellek pekiştirme: Uyku sırasında Mixture-of-Experts (MoE) yapısında önceden ayrılmış yeni, düşük dereceli “uzman” blokları açılıyor. Kısa süreli bellekteki bilgiler, bilgi damıtma (distillation) ve pekiştirmeli öğrenme tabanlı taklit yöntemleriyle bu yeni uzun süreli parametrelere aktarılıyor. Amaç, yeni bilgiyi eski parametrelerin üzerine yazmadan saklamak. Aktarım bitince geçici kısa süreli parametreler sıfırlanıyor ve bir sonraki aktif oturuma yer açılıyor.
2. Rüya ile kendini geliştirme: Model kendi sentetik eğitim örneklerini (“rüyalar”) üretiyor. Bu sırada yönlendirici rastgele farklı uzmanları devreye sokarak farklı bilgi alanlarını karıştırıyor. Üretilen örnekler gradyan tabanlı bir seçimle filtreleniyor, en yararlı görünenlerle ince ayar yapılıyor ve bunun alt görevlerde gerçekten iyileşme sağlayıp sağlamadığı değerlendiriliyor.
Araştırmacıların bildirdiği sonuçlar
Aşağıdakiler Google Research’ün kendi blog yazısında paylaşılan sonuçlar:
- Sürekli çeviri: Mançuca ve Kalamang gibi modelin daha önce görmediği dillerde, çok aşamalı değerlendirmede neredeyse sıfır performans düşüşü bildiriliyor; ICL, Cartridges ve klasik ince ayar (SFT) gibi yöntemlerin ise ciddi unutma yaşadığı belirtiliyor.
- Uzun bağlam: BABILong testinde 10 milyon token’a kadar “neredeyse kusursuz” ölçeklenme ve GPT-4 ile Titans gibi güçlü karşılaştırma modellerini geçme iddiası var.
- Yeni bilgi ekleme: SQuAD tabanlı değerlendirmede tek görevde %48,9, sürekli ön eğitim (CPT) değerlendirmesinde %46,2 sonuç ve temel model, SFT ve SEAL’e göre daha iyi performans bildiriliyor.
- Matematiksel akıl yürütme: AIME 24, AIME 25 ve HMMT 25’te sırasıyla %79,2, %69,0 ve %46,1 doğruluk; SFT, GRPO ve OPSD gibi yöntemlerden daha iyi sonuç iddiası.
Bu sonuçlar araştırma ekibinin kendi deneylerine dayanıyor. Blog yazısında yöntemin Gemini gibi bir üründe ne zaman ya da kullanılıp kullanılmayacağına dair bir bilgi yok.
Benim değerlendirmem
Benim değerlendirmem, fikrin asıl çekici tarafının modelin “eğitim” ve “kullanım” arasındaki keskin ayrımı yumuşatma hedefi olduğu yönünde. Yine de bunun şimdilik bir araştırma sonucu olduğunu unutmamak lazım. Bağımsız ekiplerin sonuçları tekrar etmesi, maliyet ve güvenlik tarafının (örneğin modelin yanlış bir bilgiyi de kalıcı olarak “pekiştirmesi” ihtimali) nasıl yönetileceği gibi sorular henüz yanıt bekliyor. Bu nedenle “devrim” demek için erken olduğunu düşünüyorum.
Sizce bir yapay zekâ asistanının konuştuklarınızdan kalıcı olarak öğrenmesi daha çok fayda mı sağlar, yoksa gizlilik ve hata riski açısından endişe mi yaratır?
Asıl kaynak: Google Research Blog – The sleep framework: A new way for LLMs to retain knowledge in continual learning: https://research.google/blog/the-sl...ms-to-retain-knowledge-in-continual-learning/