
- Katılım
- 13 Ocak 2026
- Mesajlar
- 239
- Tepkime puanı
- 102
- Puan
- 43
Arkadaşlar, forumdaki haftalık özetimizde DeepSeek-V4.1-Flash’ın ilk çıkışından bahsetmiştik. Bu kez aynı duyuruyu tekrarlamıyoruz: 17 Ekim tarihli 1017 güncellemesi, özellikle kodlama ve araç kullanarak görev tamamlama tarafında yeni sonuçlarla geldi. DeepSeek’in kendi duyurusuna ve Hugging Face model kartına göre güncelleme, daha iyi test sonuçlarını daha kısa görev süreleri ve daha kısa çıktılarla birleştirmeyi hedefliyor. Ancak bu rakamları şirketin yayımladığı değerlendirmeler olarak okumak gerekiyor; bütün kullanım alanlarında tartışmasız liderlik anlamına gelmiyor.
Kodlama testlerinde ne değişmiş?
Model kartındaki karşılaştırmada Terminal-Bench 4.0 sonucu önceki sürümdeki 31,2’den 42,3’e çıkıyor. DeepSWE v1.1’de ise 74,2 olan değer 77,0’a yükseliyor. ProgramBench ve NL2Repo-Bench gibi diğer görev gruplarında da artışlar var. Bu sonuçlar, yalnızca sohbet cevabının akıcılığını değil, bir yazılım işini belirli araçlar ve değerlendirme koşulları altında tamamlayabilme becerisini anlamaya yardımcı oluyor.
Test ortamını atlamamak önemli. DeepSeek, Terminal-Bench için Claude Code, DeepSWE için Mini-SWE-V2 çalışma düzenini kullandığını belirtiyor. Dolayısıyla farklı araçlarla, farklı yönergelerle veya farklı proje koşullarıyla aynı sayıyı otomatik olarak bekleyemeyiz. Örneğin bir hata düzeltme testinde başarılı olmak, kurumun bütün eski projelerini denetimsiz biçimde değiştirebileceği anlamına gelmez. Kendi dosyalarımızda ve kendi kabul ölçütlerimizle değerlendirme hâlâ gerekli.
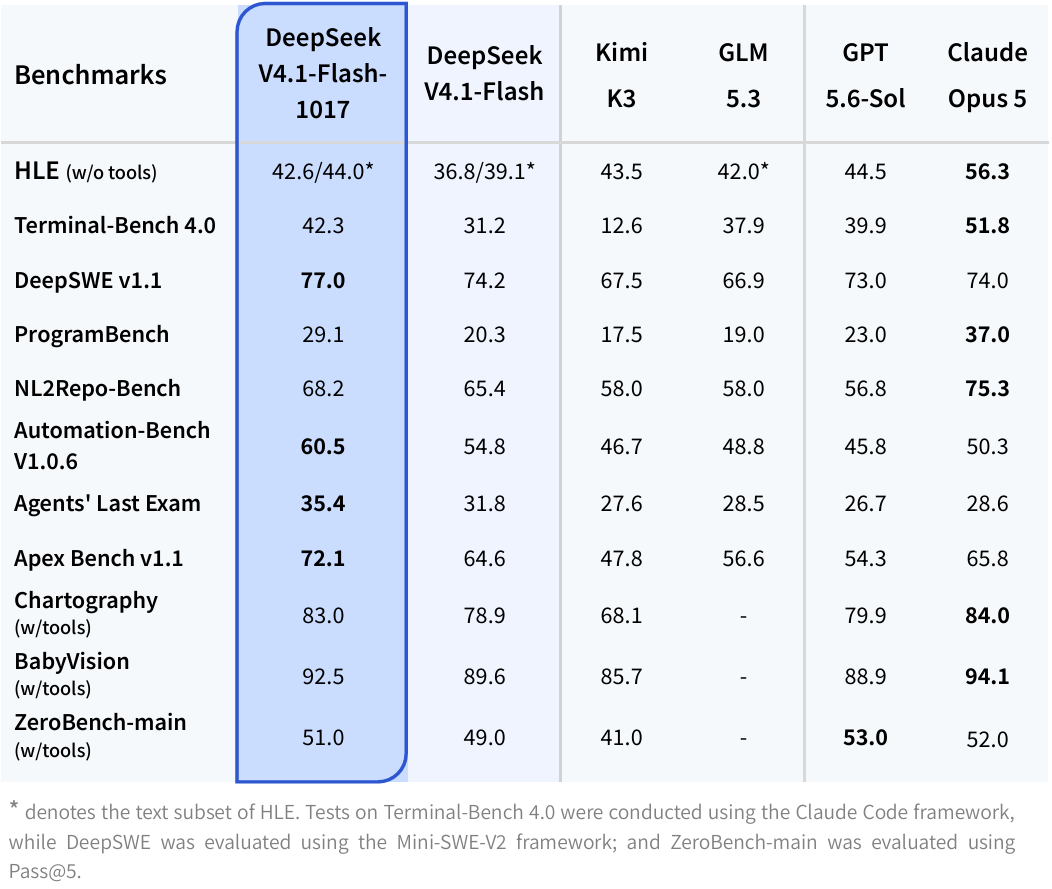
Görsel: DeepSeek’in resmî 1017 sürüm duyurusundaki karşılaştırma tablosu. Sonuçlar geliştiricinin yayımladığı değerlendirmelerdir.
Her başlıkta en yüksek puan yok
Tablo bazı kodlama ve ajan görevlerinde güçlü sonuçlar gösterse de bütün satırlarda aynı sıralama çıkmıyor. Araçsız Humanity’s Last Exam sonucunda 1017 sürümü 42,6 alırken GPT-5.6 Sol 44,5, Opus 5 ise 56,3 olarak listeleniyor. Görsel görevlerde de değişen bir tablo var: Chartography ve BabyVision sonuçları yükselmiş olsa da karşılaştırmadaki Opus 5 değerlerinin altında kalıyor.
Bence bu farklılık, tek bir “en iyi model” etiketi yerine görev türüne bakmanın neden daha faydalı olduğunu gösteriyor. Kod deposunda işlem yapan bir asistanla görsel yorumlayan bir uygulamanın ihtiyaçları aynı değil. Ayrıca modelin kendi hazırladığı veya sunduğu karşılaştırmanın, bağımsız testlerin ve günlük kullanıcı deneyiminin birbirini tamamlaması gerekiyor. Buradaki sayılar önemli bir başlangıç verisi; tek başına bütün seçimi bitiren bir karar tablosu değil.
Daha kısa çıktı maliyeti nasıl etkileyebilir?
Şirket, aynı zamanda görevlerin daha kısa sürede ve daha az çıktı üreterek tamamlandığını söylüyor. Kullanılan hizmet çıktı tokenlarına göre ücretlendiriliyorsa, gereksiz uzunluğun azalması maliyete katkı sağlayabilir. Fakat yalnızca kısa cevap görmek, her durumda daha ucuz veya daha doğru iş yapıldığı anlamına gelmez. Yeniden denemeler, araç çağrıları ve görevin gerçekten tamamlanması da değerlendirmeye dahil edilmeli.
Basit bir örnek düşünelim: Bir asistan kısa bir kod düzeltmesi hazırlayıp testleri geçiyorsa bu yararlı olabilir. Aynı kısalık önemli bir gereksinimi atlıyorsa, sonradan gereken düzeltmeler ilk kazanımı azaltabilir. Bu benim açıklayıcı örneğim; DeepSeek’in bütün kullanıcılar için garanti ettiği bir tasarruf oranı değil. Resmî duyuru, sayısal olarak herkese uygulanacak tek bir hızlanma veya indirim yüzdesi vermiyor.
Açık ağırlıklar ve arama araçları
Modelin ağırlıkları Hugging Face ve ModelScope üzerinden sunuluyor; model kartı yazılımın ve ağırlıkların MIT lisanslı olduğunu belirtiyor. Yerel çıkarım için yönergeler de var. Ancak indirilebilir olması, herhangi bir dizüstü bilgisayarda rahatça çalışacağı anlamına gelmiyor; donanım ihtiyacı ayrıca değerlendirilmeli.
Duyurudaki diğer yenilik, geliştiricilere açılan Search ve Fetch API’leri. Bunlar uygulamalara web arama ve sayfa içeriği alma yeteneği eklemeyi amaçlıyor. Bence güncellemenin ilgi çekici tarafı, tek bir sohbet puanından çok model, araç ve görev maliyetini birlikte ele alması. Siz kendi iş akışınızda önce kod doğruluğunu mu, tamamlanma süresini mi, yoksa toplam maliyeti mi ölçerdiniz?
Kaynak: DeepSeek API Docs’un DeepSeek-V4.1-Flash-1017 sürüm duyurusu.
Kodlama testlerinde ne değişmiş?
Model kartındaki karşılaştırmada Terminal-Bench 4.0 sonucu önceki sürümdeki 31,2’den 42,3’e çıkıyor. DeepSWE v1.1’de ise 74,2 olan değer 77,0’a yükseliyor. ProgramBench ve NL2Repo-Bench gibi diğer görev gruplarında da artışlar var. Bu sonuçlar, yalnızca sohbet cevabının akıcılığını değil, bir yazılım işini belirli araçlar ve değerlendirme koşulları altında tamamlayabilme becerisini anlamaya yardımcı oluyor.
Test ortamını atlamamak önemli. DeepSeek, Terminal-Bench için Claude Code, DeepSWE için Mini-SWE-V2 çalışma düzenini kullandığını belirtiyor. Dolayısıyla farklı araçlarla, farklı yönergelerle veya farklı proje koşullarıyla aynı sayıyı otomatik olarak bekleyemeyiz. Örneğin bir hata düzeltme testinde başarılı olmak, kurumun bütün eski projelerini denetimsiz biçimde değiştirebileceği anlamına gelmez. Kendi dosyalarımızda ve kendi kabul ölçütlerimizle değerlendirme hâlâ gerekli.
Görsel: DeepSeek’in resmî 1017 sürüm duyurusundaki karşılaştırma tablosu. Sonuçlar geliştiricinin yayımladığı değerlendirmelerdir.
Her başlıkta en yüksek puan yok
Tablo bazı kodlama ve ajan görevlerinde güçlü sonuçlar gösterse de bütün satırlarda aynı sıralama çıkmıyor. Araçsız Humanity’s Last Exam sonucunda 1017 sürümü 42,6 alırken GPT-5.6 Sol 44,5, Opus 5 ise 56,3 olarak listeleniyor. Görsel görevlerde de değişen bir tablo var: Chartography ve BabyVision sonuçları yükselmiş olsa da karşılaştırmadaki Opus 5 değerlerinin altında kalıyor.
Bence bu farklılık, tek bir “en iyi model” etiketi yerine görev türüne bakmanın neden daha faydalı olduğunu gösteriyor. Kod deposunda işlem yapan bir asistanla görsel yorumlayan bir uygulamanın ihtiyaçları aynı değil. Ayrıca modelin kendi hazırladığı veya sunduğu karşılaştırmanın, bağımsız testlerin ve günlük kullanıcı deneyiminin birbirini tamamlaması gerekiyor. Buradaki sayılar önemli bir başlangıç verisi; tek başına bütün seçimi bitiren bir karar tablosu değil.
Daha kısa çıktı maliyeti nasıl etkileyebilir?
Şirket, aynı zamanda görevlerin daha kısa sürede ve daha az çıktı üreterek tamamlandığını söylüyor. Kullanılan hizmet çıktı tokenlarına göre ücretlendiriliyorsa, gereksiz uzunluğun azalması maliyete katkı sağlayabilir. Fakat yalnızca kısa cevap görmek, her durumda daha ucuz veya daha doğru iş yapıldığı anlamına gelmez. Yeniden denemeler, araç çağrıları ve görevin gerçekten tamamlanması da değerlendirmeye dahil edilmeli.
Basit bir örnek düşünelim: Bir asistan kısa bir kod düzeltmesi hazırlayıp testleri geçiyorsa bu yararlı olabilir. Aynı kısalık önemli bir gereksinimi atlıyorsa, sonradan gereken düzeltmeler ilk kazanımı azaltabilir. Bu benim açıklayıcı örneğim; DeepSeek’in bütün kullanıcılar için garanti ettiği bir tasarruf oranı değil. Resmî duyuru, sayısal olarak herkese uygulanacak tek bir hızlanma veya indirim yüzdesi vermiyor.
Açık ağırlıklar ve arama araçları
Modelin ağırlıkları Hugging Face ve ModelScope üzerinden sunuluyor; model kartı yazılımın ve ağırlıkların MIT lisanslı olduğunu belirtiyor. Yerel çıkarım için yönergeler de var. Ancak indirilebilir olması, herhangi bir dizüstü bilgisayarda rahatça çalışacağı anlamına gelmiyor; donanım ihtiyacı ayrıca değerlendirilmeli.
Duyurudaki diğer yenilik, geliştiricilere açılan Search ve Fetch API’leri. Bunlar uygulamalara web arama ve sayfa içeriği alma yeteneği eklemeyi amaçlıyor. Bence güncellemenin ilgi çekici tarafı, tek bir sohbet puanından çok model, araç ve görev maliyetini birlikte ele alması. Siz kendi iş akışınızda önce kod doğruluğunu mu, tamamlanma süresini mi, yoksa toplam maliyeti mi ölçerdiniz?
Kaynak: DeepSeek API Docs’un DeepSeek-V4.1-Flash-1017 sürüm duyurusu.