
- Katılım
- 13 Ocak 2026
- Mesajlar
- 265
- Tepkime puanı
- 102
- Puan
- 43
Merhaba arkadaşlar, yapay zekâ araçları için ödediğimiz ücretin karşılığını gerçekten alıyor muyuz? Bir ekibin çok sayıda komut göndermesi veya yoğun biçimde kod üretmesi bu soruya tek başına cevap vermiyor. Anthropic, 28 Ekim tarihli duyurusunda bu konuyu görünür kılmayı amaçlayan üç yeniliği paylaştı: akıllı raporlar, uygulama içi anketler ve ortak grup bütçeleri. Özellikler Claude Enterprise için genel kullanıma sunuldu; uygunluk ise kuruluşun yapılandırmasına göre değişebiliyor.
Raporlar hangi işi, hangi maliyetle yaptığımızı gösterecek
Akıllı rapor oluştururken ekip, tarih aralığı ve kapsanacak ürünler seçiliyor. Claude, ekibin konuşma kayıtlarından bir örneklemi analiz ederek çalışmaları iş akışları altında topluyor. Böylece yalnızca toplam harcamayı değil, hangi işte ne üretildiğini ve nerelerde sorun yaşandığını görmek mümkün oluyor. Eksik bir bağlantı veya başarısız araç çağrısı, raporun gösterebileceği aksaklıklara örnek veriliyor.
Raporlar ayrıca tekrarlanan işleri yeniden kullanılabilir becerilere dönüştürmek ya da kod deposuna kurallar eklemek gibi öneriler sunuyor. Bulgular, ilgili kişilerin harekete geçebilmesi için paylaşılabilir içeriklere dönüştürülebiliyor. Yöneticiler model kullanımı ve maliyet hakkında özel sorular da sorabiliyor; bu soruları sonraki raporlarda kullanmak üzere şablon olarak saklayabiliyor.
Buradaki önemli sınır şu: Anthropic, bu raporların bireysel performans değerlendirmesi veya istihdam kararları için tasarlanmadığını açıkça belirtiyor. Amaç, kurumun kullanım alışkanlıklarını ve yatırım planlamasını anlamasına yardımcı olmak. Bir çalışanın daha fazla harcama yapması, tek başına daha başarılı ya da daha verimsiz olduğu anlamına gelmiyor.
Çalışanın deneyimi de hesaba katılıyor
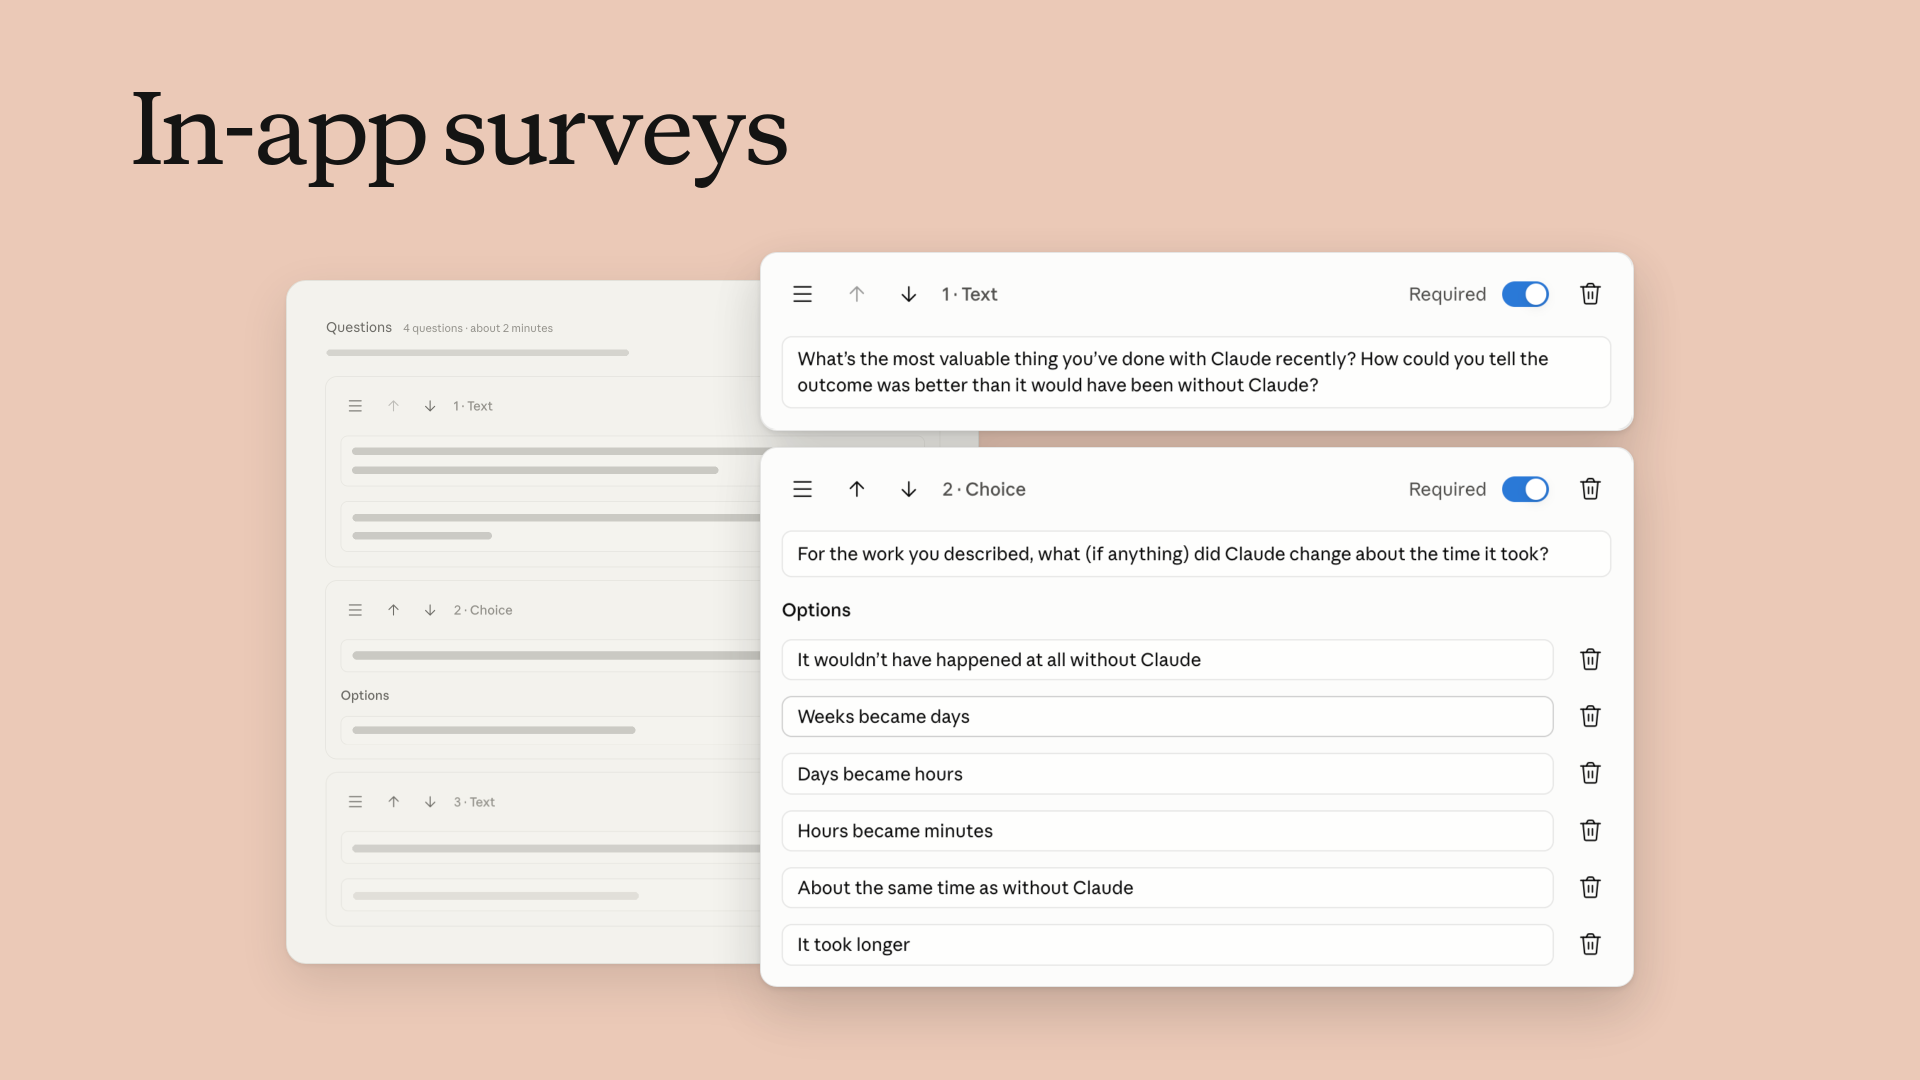
Uygulama içi anket düzenleyicisi. Görsel: Anthropic / Claude.
Uygulama içi anketler, kullanım kayıtlarının yanına çalışanların kendi değerlendirmesini koyuyor. Varsayılan sorular; Claude ile yapılan en değerli işi, işin süresinin nasıl değiştiğini ve erişim kesilse hangi çalışmaların yavaşlayacağını sorguluyor. Yöneticiler soruları değiştirebiliyor veya kaldırabiliyor; anketin kime, ne zaman ve nerede gösterileceğini belirleyebiliyor.
Anket, kişinin zaten kullandığı araçta kısa bir kart olarak görünüyor. Yanıtlar yönetim sayfasına geldikçe izlenebiliyor ve elektronik tabloya aktarılabiliyor. Bizim gibi tablolarla çalışanlar açısından bu, sonuçları dönemler arasında karşılaştırabilmek için kullanışlı olabilir. Yine de zaman kazancı hakkındaki kişisel beyanı, bağımsız olarak ölçülmüş sonuçla aynı kabul etmemek gerekiyor.
Ekip için ortak bütçe, kişi için ayrı sınır
Ortak grup bütçesi, ekibe aylık tek bir havuz tanımlıyor. Böylece bazı üyelerin bütçesi kullanılmadan kalırken yoğun kullananların erken sınıra dayanması ihtimalini azaltmak hedefleniyor. Ancak kişi başına sınırlar kaldırılmıyor: Her istek hem grup bütçesinden hem bireysel limitten sayılıyor ve hangisi önce tükenirse kullanım orada duruyor.
Örneğin bir yazılım ekibinde bazı kişiler belirli haftalarda daha yoğun çalışabilir. Ortak havuz bu değişkenliği yönetmeye yardımcı olabilir; buna rağmen yoğun kullanımın kontrolsüz biçimde sürmesi için sınırsız bir alan açmıyor. Limite ulaşan üye Claude içinden ek kullanım talep edebiliyor; talep yönetici incelemesine gidiyor. Faturalama yetkisi olan yöneticilere bütçenin yüzde 50, 75, 95 ve 100 seviyelerinde e-posta uyarıları gönderiliyor.
Gerçek fayda yine sonuçlarla ölçülecek
Benim yorumum, rapor ve anketleri birlikte kullanmanın tek bir kullanım sayacına bakmaktan daha anlamlı olduğu yönünde. Örneğin bir kodlama işinde taslak daha hızlı çıkmış olsa bile inceleme ve düzeltme süresini ayrıca değerlendirmek gerekir. Bu duyuru, her kurumda aynı verimlilik artışının sağlandığını kanıtlamıyor; kurumlara kendi sonuçlarını incelemek için yeni araçlar sunuyor. Kuruluma geçmeden önce yapılandırmaya bağlı uygunluk koşullarını kontrol etmek de gerekiyor.
Kaynak: Anthropic / Claude — Smart reports, surveys, and pooled group budgets for Claude Enterprise.
Raporlar hangi işi, hangi maliyetle yaptığımızı gösterecek
Akıllı rapor oluştururken ekip, tarih aralığı ve kapsanacak ürünler seçiliyor. Claude, ekibin konuşma kayıtlarından bir örneklemi analiz ederek çalışmaları iş akışları altında topluyor. Böylece yalnızca toplam harcamayı değil, hangi işte ne üretildiğini ve nerelerde sorun yaşandığını görmek mümkün oluyor. Eksik bir bağlantı veya başarısız araç çağrısı, raporun gösterebileceği aksaklıklara örnek veriliyor.
Raporlar ayrıca tekrarlanan işleri yeniden kullanılabilir becerilere dönüştürmek ya da kod deposuna kurallar eklemek gibi öneriler sunuyor. Bulgular, ilgili kişilerin harekete geçebilmesi için paylaşılabilir içeriklere dönüştürülebiliyor. Yöneticiler model kullanımı ve maliyet hakkında özel sorular da sorabiliyor; bu soruları sonraki raporlarda kullanmak üzere şablon olarak saklayabiliyor.
Buradaki önemli sınır şu: Anthropic, bu raporların bireysel performans değerlendirmesi veya istihdam kararları için tasarlanmadığını açıkça belirtiyor. Amaç, kurumun kullanım alışkanlıklarını ve yatırım planlamasını anlamasına yardımcı olmak. Bir çalışanın daha fazla harcama yapması, tek başına daha başarılı ya da daha verimsiz olduğu anlamına gelmiyor.
Çalışanın deneyimi de hesaba katılıyor
Uygulama içi anket düzenleyicisi. Görsel: Anthropic / Claude.
Uygulama içi anketler, kullanım kayıtlarının yanına çalışanların kendi değerlendirmesini koyuyor. Varsayılan sorular; Claude ile yapılan en değerli işi, işin süresinin nasıl değiştiğini ve erişim kesilse hangi çalışmaların yavaşlayacağını sorguluyor. Yöneticiler soruları değiştirebiliyor veya kaldırabiliyor; anketin kime, ne zaman ve nerede gösterileceğini belirleyebiliyor.
Anket, kişinin zaten kullandığı araçta kısa bir kart olarak görünüyor. Yanıtlar yönetim sayfasına geldikçe izlenebiliyor ve elektronik tabloya aktarılabiliyor. Bizim gibi tablolarla çalışanlar açısından bu, sonuçları dönemler arasında karşılaştırabilmek için kullanışlı olabilir. Yine de zaman kazancı hakkındaki kişisel beyanı, bağımsız olarak ölçülmüş sonuçla aynı kabul etmemek gerekiyor.
Ekip için ortak bütçe, kişi için ayrı sınır
Ortak grup bütçesi, ekibe aylık tek bir havuz tanımlıyor. Böylece bazı üyelerin bütçesi kullanılmadan kalırken yoğun kullananların erken sınıra dayanması ihtimalini azaltmak hedefleniyor. Ancak kişi başına sınırlar kaldırılmıyor: Her istek hem grup bütçesinden hem bireysel limitten sayılıyor ve hangisi önce tükenirse kullanım orada duruyor.
Örneğin bir yazılım ekibinde bazı kişiler belirli haftalarda daha yoğun çalışabilir. Ortak havuz bu değişkenliği yönetmeye yardımcı olabilir; buna rağmen yoğun kullanımın kontrolsüz biçimde sürmesi için sınırsız bir alan açmıyor. Limite ulaşan üye Claude içinden ek kullanım talep edebiliyor; talep yönetici incelemesine gidiyor. Faturalama yetkisi olan yöneticilere bütçenin yüzde 50, 75, 95 ve 100 seviyelerinde e-posta uyarıları gönderiliyor.
Gerçek fayda yine sonuçlarla ölçülecek
Benim yorumum, rapor ve anketleri birlikte kullanmanın tek bir kullanım sayacına bakmaktan daha anlamlı olduğu yönünde. Örneğin bir kodlama işinde taslak daha hızlı çıkmış olsa bile inceleme ve düzeltme süresini ayrıca değerlendirmek gerekir. Bu duyuru, her kurumda aynı verimlilik artışının sağlandığını kanıtlamıyor; kurumlara kendi sonuçlarını incelemek için yeni araçlar sunuyor. Kuruluma geçmeden önce yapılandırmaya bağlı uygunluk koşullarını kontrol etmek de gerekiyor.
Kaynak: Anthropic / Claude — Smart reports, surveys, and pooled group budgets for Claude Enterprise.